用 Cherry Studio 把多个 AI 模型变成外贸内容工作站
一、外贸内容生产,耗人的从来不是”写”
做过外贸内容的人都懂这个场景:写一篇英文产品文,要开一个窗口问模型措辞,开一个窗口查术语,开一个窗口让另一个模型润色,资料散在微信文件、邮件附件和本地文件夹里。真正花在”想清楚要写什么”上的时间,反而被反复切换、反复粘贴稀释掉了。
更麻烦的是多语言。一个产品要出英文主站版、西语拉美版、阿语版,每换一个语言就重开一轮对话,上下文全丢,前后术语还不一致——上周管”数控车床”叫 CNC lathe,这周变成 CNC turning machine,客户看着就别扭。
这些问题的根源不是你不够熟练,而是工具形态不对:网页版聊天窗是”一次性对话”,而内容生产需要的是”可复用的流水线”。
二、Cherry Studio 是什么:一个壳,三种接法
简单说,它是一个多模型 AI 客户端:把 OpenAI、ClaudeClaude、Gemini、国产大模型以及本地部署的开源模型,全部装进同一个桌面界面里。但它对外贸运营者真正的价值,是三个”可复用”:
- 助手可保存:把你调好的提示词(比如”你是资深工业品文案,按 AIDA 结构写 800 词英文产品页”)存成助手,下次一键调用,不用每次重写提示词。
- 知识库可挂载:把产品手册、认证证书、常见问答文档丢进去,模型回答时能检索你自己的资料,而不是凭通用知识瞎编。
- 多模型可对比:同一个问题同时问两三个模型,谁的术语更准、谁的结构更好,一目了然——写关键页面时这一步能省掉大量返工。
模型怎么接进来,有三条路,成本和安全级别各不相同,按你的数据敏感度选:
接法适合谁成本数据去向云端 API Key大多数团队,图省事按量付费,量大可换中转请求发往模型服务商国内中转 API网络环境不稳定时通常略低于官方请求发往中转商,先看它的隐私条款本地开源模型涉密内容、长期大批量一次性硬件投入不出本机,涉密资料只能用这条
给涉密内容划条死线:核心工艺参数、未公开报价,只走本地模型,别图方便粘进任何云端对话框——包括”应该没事”的内部测试。
三、上手半小时:初始化清单
工具装起来很快,但”装好”和”能用”之间隔着一次认真的初始化。按这个清单走,半小时后你手里就有个能干活的雏形:
- 选一条模型接入路径:先只用一种模型跑通(推荐一个主力云端 API),别第一天就把五个渠道全配上——排查问题时你会感谢自己。
- 建三个种子助手:产品描述助手、FAQ 助手、邮件润色助手。提示词先别追求完美,能跑就行,后面靠迭代。
- 传第一批文档:挑 10 份”最常被问”的资料进知识库(手册、认证、报价单模板、FAQ 整理),控制在二十份以内——库不是仓库,求精不求多。
- 跑一次对比测试:同一个问题(如”写一段 80 词的数控车床简介”)问两个模型,直观感受差异,顺便熟悉界面。
- 定一套命名规则:助手名带用途(
产品描述-工业设备),知识库目录带分类(01-产品手册/02-认证/03-客户沟通)。规则从第一天就定,三个月后你会回来谢自己。
这五步做完,工具已经从”下载好了”变成”在工作了”。剩下的全是往里添东西,每周加一点。
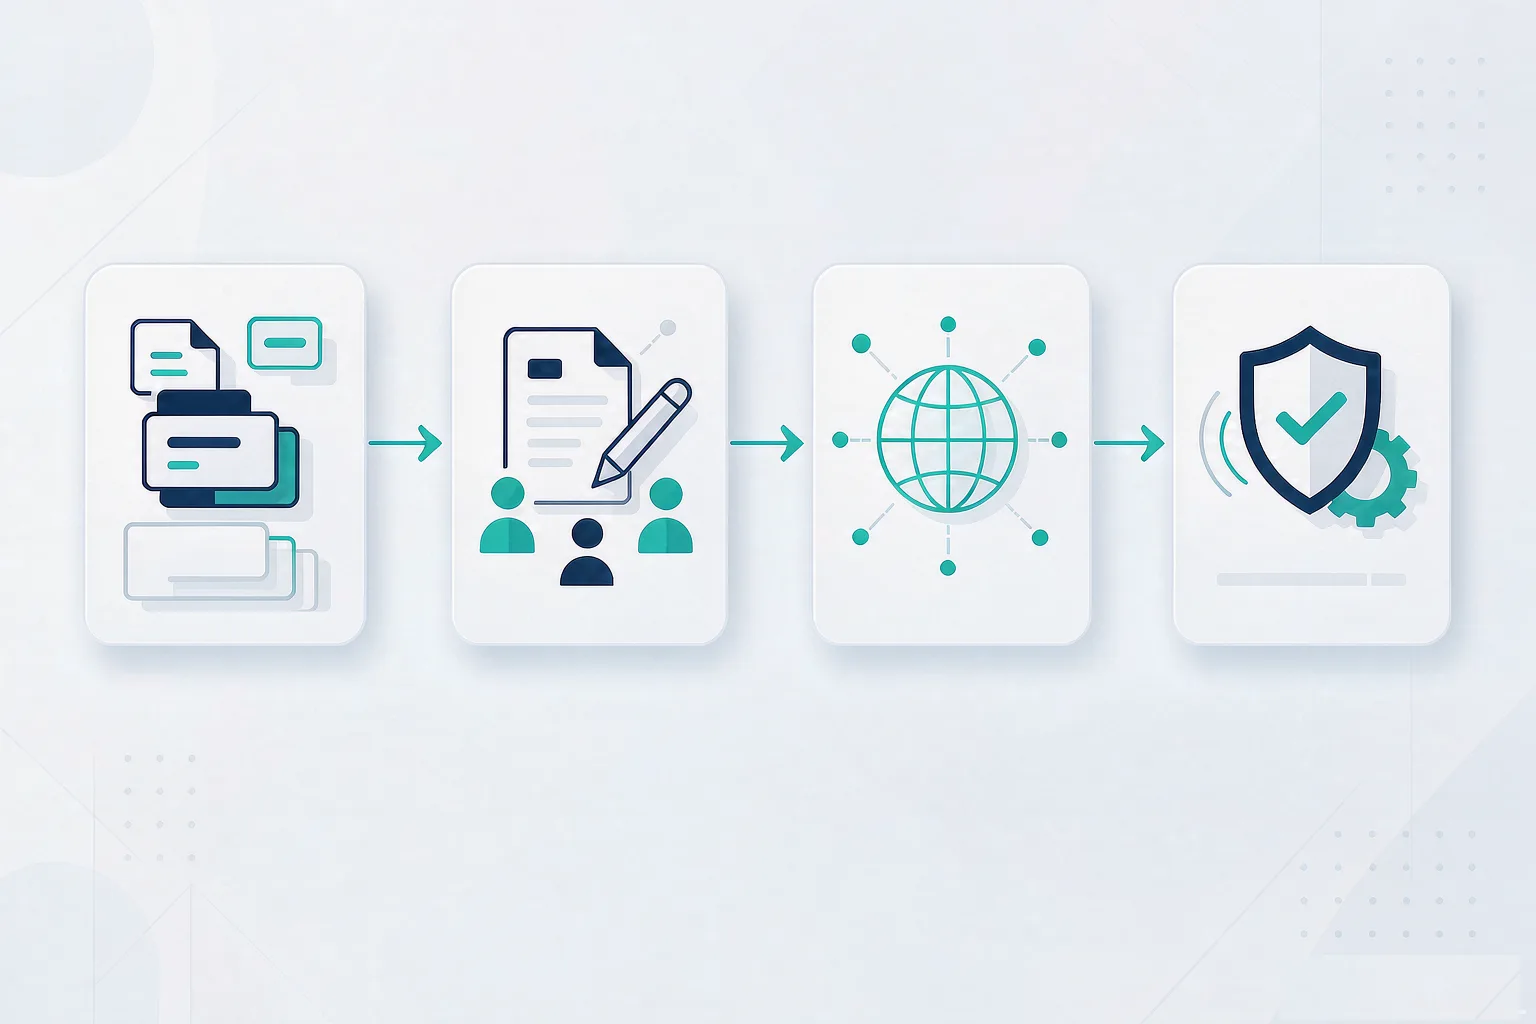
四、搭一套外贸内容工作流:四个模块
工具本身不产生价值,搭法才产生价值。给你一套验证过的四模块结构:
模块一:选题库(输入)
把客户常问的问题、询盘记录里的高频词、行业报告摘录,统一整理成几个文档放进知识库。内容选题从”拍脑袋”变成”从真实提问里捞”——这件事的完整逻辑在用 ChatLog 把客户聊天记录变成外贸内容选题库用 ChatLog 把客户聊天记录变成外贸内容选题库里展开讲过,聊天记录导出来、脱敏、聚类,沉淀的就是这个库的原料。
模块二:成稿车间(生产)
给每个内容类型建一个固定助手:产品描述助手、行业解决方案助手、公司新闻助手、FAQ 助手。提示词里写死结构(标题层级、要点数量、语气),出来的稿子格式稳定,后期编辑成本大幅下降。改稿时只改一个助手,全系列内容同步升级——这是”可复用”真正的复利。
模块三:多语言本地化(分发)
英文定稿后,用同一个助手、同一份术语表,逐语言输出西语、法语、阿语版本。术语表也放进知识库,模型每次都会检索,跨语言术语一致性问题就这么解决。注意:机器翻译管初稿,本地化表达(比如拉美西语和西班牙西语的用词差异)要人工过一遍。
模块四:质检关(把关)
模型负责速度,你负责准确。参数、认证编号、交期、价格,这四类硬信息发前逐条核对——AI 会在这些细节上自信地编造,GEO 决策证据那篇GEO 决策证据那篇把这个坑讲得很透:不是模型坏,是它没有”不确定就说不知道”的机制,除非你的提示词逼它有。
五、一个完整例子:从询盘到多语言产品文
光说结构不够直观,走一遍真实流程。假设你刚收到一封德国询盘,问某系列设备的能耗参数和认证情况:
- 归档:询盘原文存进知识库的”客户沟通”目录(脱敏处理后);
- 拆解:问工作台”这封询盘里客户真正关心的三个点是什么”,模型基于原文列出:能耗合规、认证范围、交货周期;
- 成稿:调用产品描述助手,让它基于手册和认证文档,写一篇 800 词的英文产品文,重点回应这三点;
- 本地化:同一助手 + 术语表,输出德语版;
- 质检:你核对文中的参数、认证编号与源文档一致性,发布。
注意第 2 步和第 5 步:前者让内容从”客户真实提问”里长出来,后者保证 AI 没有在细节上自由发挥。中间全是机器速度,两头是你的判断。同样一封询盘,以前只回一封信;现在除了回信,还长出一篇产品文和它的德语版——一封询盘的内容杠杆,就是这么撬起来的。
六、一周内容节奏怎么排
很多人的问题是”有工具没节奏”,给你一个能落地的周更模板:
- 周一:把上周询盘和新出现的问题丢进选题库,让模型基于知识库列出 5 个候选选题,你圈 2 个。
- 周二三:成稿助手出初稿,你改结构和事实,不纠结措辞。
- 周四:多语言版本批量输出,只审术语和本地化表达。
- 周五:质检关过一遍硬信息,排期发布。
一周两篇多语言内容,靠的不是灵感,是这套固定动作。前四周会觉得”比我自己写还麻烦”(因为助手和知识库还在调),第四周开始节奏才会顺——工具的红利从来不在第一天。
七、知识库的检索质量,是这么调出来的
多数人用知识库的体验是”问了三遍答不到点上”,然后结论”AI 不好用”。其实九成是库没调好。三个可操作的调优动作:
1. 目录分组,别一锅粥
按”产品/认证/客户沟通/行业资料”分目录建来源分组。问产品问题就限定在产品组检索——不然营销文案里的形容词会污染技术回答。分组清晰的库,回答质量能差出一整个档次。
2. 长文档切块
手册 PDF 动辄几十页,整份丢进去,检索时定位不准。按章节拆成多个文档(产品手册-第3章-技术参数.md),每份一个主题。拆得越细,引用越准。
3. 术语表常驻
把”公司标准译法”整理成一份常驻文档(产品名、认证名、材质名的固定中英对照)。每次回答模型都会参考它——这是跨语言术语一致的根子上的解法,比每次在提示词里重申管用。
4. 季度清理
手册改版、认证换版,旧文档还躺在库里,它就会一本正经地引用作废参数。给库排一个季度复审日程:删过期、更新版本、合并重复。库的干净程度,直接等于答案的可靠程度。
八、三个常见误区
- 误区一:助手建得越多越好。结果是一个头衔一个助手,调的时候还得回忆用哪个。正确做法是按内容类型建(产品文/解决方案/新闻),控制在五个以内。
- 误区二:知识库一次性喂饱。丢进去几百份文档不整理,检索质量反而下降。按目录分门别类、定期清理过期文档,比堆量重要。
- 误区三:追求”全自动发布”。内容生产可以工业化,但发布前的把关不能省。把 AI 定位成”初稿机器”而不是”责任编辑”,心态就对了。
九、两个能直接抄的提示词模板
工作台的价值最终落在助手的提示词上。给你两个底子,按你的行业替换括号内容即可:
产品描述助手:你是(工业设备/消费品)行业的资深文案。基于我提供的产品手册和认证文档,写一篇 800 词的英文产品页。要求:1. 标题层级为 H2,分”核心优势/技术参数/应用场景/合作方式”四节;2. 每个技术参数必须引用我提供的文档,不得自行补充;3. 语气专业但不生硬,避免最高级形容词;4. 结尾用一句行动号召。
FAQ 助手:基于我提供的客户沟通记录和产品文档,列出采购商最常问的 10 个问题,每个问题给出:标准回答(引用文档原文)、回答里必须避免的表述(如绝对化承诺)、对应的内部责任人。按”被问频次”从高到低排。
配合知识库里的手册文档,第一个助手出来的稿子,后期编辑量能压到三成以内。提示词改三轮就稳定下来,之后每次调用都是省时间。
十、红线:工具是放大器,不是免检章
- 知识库喂什么,模型信什么:过期价格、错误参数传上去,它会一丝不苟地引用。资料进库前先清理。
- 涉密资料别上图:客户端可以接云端模型,核心工艺参数、未公开报价这类内容,宁可本地部署模型处理。
- 产出必须人工过一遍:尤其是面向采购商的技术文案,一个错误参数毁掉的是专业信任。
内容生产的竞争,早就不比谁写得快,而比谁的流程稳。把散落的模型能力收拢成一张工作台,你才从”每次重开一局”变成”越用越顺手”。先把最常用的那个助手存下来,就是开始。
常见问题(FAQ)
Cherry Studio 收费吗?
客户端本身免费开源,模型费用取决于你填的 API 供应商;也可以接入本地部署的开源模型,完全零成本,只是效果看机器配置。
和直接用网页版 ChatGPT 有什么区别?
最大区别是”可复用”:助手、知识库、提示词都能存下来反复调用,还能同时对比多个模型的输出,不用每次重新开对话、重新贴资料。
生成的文案能直接发到网站上吗?
不能直接发。AI 产出必须经过事实核验和人工润色,尤其是参数、认证、交期这类硬信息,发之前逐条核对过再上线。