我给外贸独立站做 AI 询盘助手时,怎么让 LLM 不胡说(RAG/提示工程/合规擦除实录)
外贸独立站的流量很贵,但大多数站点在访客最想问问题的深夜、周末、节假日却”无人值守”。我做的 LifelineVerve · 恒线智讯 就是想把这个缺口补上:把网站从一块被动的展示牌,变成一个有温度、永不离线的 AI 接待前台。访客随时提问,AI 即时应答、理解需求,最终把高价值对话沉淀为可追踪、可分配的销售线索。
但真正动手后第一个被扇脸的问题不是”怎么接模型”,而是:通用 LLM 会胡说。 它会编出你产品线里根本不存在的型号、报出你没授权的价格、顺手把别的客户的案例当成自己的讲,甚至越过边界去回答敏感合规问题。对一个要替你接单的”前台”来说,这是致命的。
这篇就是我这一路的实录:怎么把 LLM 锁在自家资料里、让它讲人话、还顺带满足数据合规。
一、先理清楚:对话闭环长什么样
在谈”怎么不让它胡说”之前,得先知道一句话从访客到销售经历了什么。LifelineVerve 的核心闭环是:
网站前端 widget → 大模型(含兜底失败转移)→ 对话与线索落 DB → 后台线索管理(筛选/已读/分配)→ 邮件转发给业务员 → 分配跟进
这个链路里,模型不是终点,而是中间一环。它产出的每一句回答和每一条提取出的客户意图,都要能回溯、能分配、能审计。这个”可回溯”的约束,恰恰是后面三道防线的总纲。
二、第一道防线:RAG / 知识库检索,别让模型靠”记忆”答题
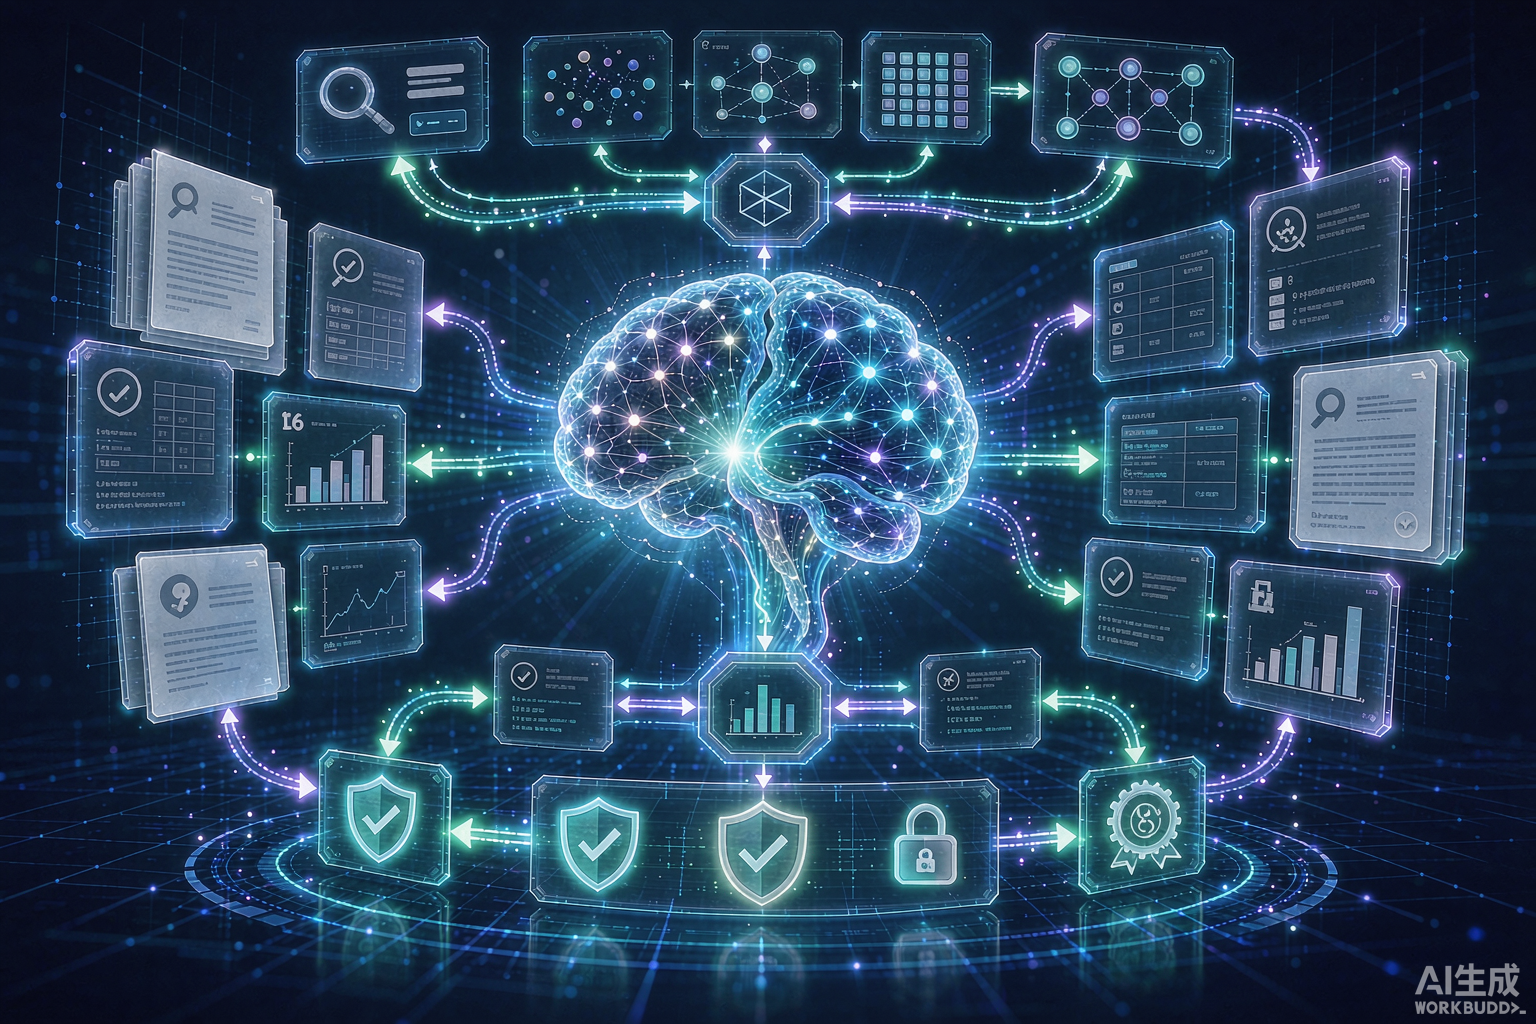
LLM 的”知识”是训练时塞进去的,你根本控制不了它会想起什么、又会编出什么。所以第一条铁律:凡是涉及你自家产品、价格、政策、案例的回答,一律不许模型凭记忆,必须从知识库里检索出来再答。
具体做法:
- 把资料切成合适的 chunk:产品手册、FAQ、 shipping 政策、真实成交案例分别建索引。chunk 太大,检索回来的上下文里噪声多;太小,又容易断章取义。我踩过的坑是初期 chunk 设得过大,导致一次检索塞回来半本手册,模型反而被带偏。
- 混合检索比单用向量稳:纯向量检索对”精确型号/参数”这类关键词召回很差,BM25 反而更准。最终我用了 BM25 + 向量的混合检索,再按相关性重排,召回质量明显更稳。
- 检索结果要带溯源:回答里引用的每一条,都要求标注它来自哪个文档片段。这既是给用户信心,也是给后面合规擦除留审计痕迹。
换句话说,RAG 把”模型答题”变成了”模型基于证据综述”——它再怎么发挥,也被钉死在你给的那几页资料上。
三、第二道防线:系统提示工程,把角色和边界焊死
光有检索还不够,模型拿到资料后仍可能”自由发挥”。我在系统提示(system prompt)里锁定了三件事:
- 角色与边界:明确它是”某品牌外贸独立站的售前接待”,只回答与该品牌产品、行业、采购相关的问题;越界问题礼貌拒答并引导留资。
- 输出约束:要求结构化、用客户的语言(别堆术语)、不确定的事明说”建议联系业务员”,严禁编造型号/价格/交期。
- 强制留资:当识别到高意向(要报价、要样品、问 MOQ)时,主动引导留邮箱/WhatsApp,而不是滔滔不绝。
提示工程不是写一句”请诚实回答”就完事。它是把你的业务规则翻译成模型能遵守的指令,而且要反复用真实对话去压测、去补漏洞。我每发现模型一次越界,就往系统提示里补一条”禁止情形 + 正确示范”。
四、第三道防线:合规擦除,数据出不了问题
外贸站面对的是全球客户,隐私与信息保护不是可选项。对话里会自然流出客户的邮箱、公司、采购意图——这些一旦泄露或滥用,就是合规事故。
我的处理是合规擦除:
- 按邮箱匿名化:线索落库时,敏感字段按邮箱哈希脱敏,原始明文只在授权场景可见。
- 审计日志:谁在什么时候查看了哪条线索、做了什么操作,全部留痕。出事能查、能举证。
- 可擦除:客户要求删除时,按邮箱定位并清除对应记录,满足”被遗忘权”类诉求。
这层不性感,但它是”敢把对话转成线索”的前提。没有它,前面两道防线再漂亮也不敢真上线。
五、真实踩过的坑(都是钱换来的)
- 长上下文截断:检索回来的片段一多,超过上下文窗口就被默默截断,模型答非所问。解决是控制单次检索数量 + 重排取 Top-K。
- 检索相关性幻觉:模型拿到不相关的片段,却很自信地基于它编答案。混合检索 + 要求”无依据就明说不知道”显著缓解。
- 并发与失败转移:模型 API 偶发 5xx,没兜底整个对话就断。我加了多模型兼容 + 失败转移,一个挂了切另一个,对话不中断。
- Dify 后端 vs 自研:托管方案(如 Dify)上手快,但数据要出域;自研可控、能直接落自家 DB 和合规逻辑,代价是工程量。我的判断是:数据合规红线内的,必须自研或可控部署。
六、为什么这件事本身值得写
回头看,这套”RAG + 提示工程 + 合规擦除”的打法,我没有抄任何教程——它是我在 独立站从 0 到询盘 的真实项目里,被模型一次次胡说扇出来的经验。写出来,它直接成了 LifelineVerve 的产品知识与开发文档;对我也成了可检索、可复用的团队知识库资产。
这就是我做内容的一贯标准:写自己正在做的事,把 tacit 经验 crystallize 成一手知识库。角度是一手的,竞品抄不走;长尾流量只是副产品。
如果你也在给自己的站点接 AI 助手,记住这句话就够了——别让模型凭记忆答题,把它钉死在你给的证据上,再给数据合规上一把锁。
下一篇我会写:我让 AI 每天自动发 1 篇英文文章到第 N 天,B2B 双站的实际流量和收录到底发生了什么。那是另一条”做中学”的线。